手上有两台一模一样的 DGX Spark——具体来说是 HP 的贴牌版 ZGX Nano G1n(NVIDIA GB10,128 GB 统一内存)。这两天把它们用 QSFP 直连组了个双机环境,拿来跑本地大模型推理,实际用的测试工况是 TensorFold(TP=2)部署 EXL3 2.9bpw 量化版的 DeepSeek-V4.1-Flash。
部署本身没遇到什么大波折,服务顺利拉起来了,速度也符合预期(写代码 100 tok/s 出头,中文 64 tok/s 左右)。但真开始干活以后,怪事来了:只要连续来几轮请求,其中一台机器(下面叫 spark0)就会毫无征兆地整机断电——三个网口瞬间失联,整机彻底断电,必须人走过去按开机键,就像被人直接拔了电源线一样。
而旁边配置、系统、固件完全一样的另一台 spark1,什么事都没有。
排查了一整天,最后挖出来的问题其实和模型本身没什么关系,反倒是把 DGX Spark 这类紧凑型桌面 AI 机器在硬件个体差异、供电余量和默认加速策略上的隐患暴露了个底朝天。这里把排查过程和最后的无损规避方案记下来,给同样在用 DGX Spark(或者各家 GB10 贴牌机)的朋友做个参考。
常规嫌疑全部排除:不是内存,不是过热,也不是固件
遇到这种突然掉电,第一反应自然是先往最常见的方向查。
最先怀疑的是统一内存耗尽卡死。GB10 是 128 GB 统一内存,两台机器装完模型和 KV cache 后,空闲内存确实绷得很紧,只剩 4–5 GiB。为了确认是不是 OOM 把系统拖死了,我专门加了个简单的内存守护脚本,每 0.25 秒读一次 /proc/meminfo 并立即落盘,可用内存连续两次低于 1.25 GiB 就直接杀掉本机推理容器保命。结果复测时 spark0 照样断电,翻开落盘日志一看,断电前可用内存稳稳停在 3.6–4.7 GiB,根本没往下掉。后来写单机复现测试时,断电瞬间机器甚至还有 104 GiB 空闲内存——内存彻底洗清嫌疑。
排除了内存,剩下的常见原因就是过热保护和内核崩溃。于是把监控改成每 100 毫秒采样一次 GPU 功耗、频率和 SoC 温度,同样逐行实时落盘,确保能抓到断电前最后一刻的状态。拿到的数据反而更让人意外:
- 温度很低:几次断电时,SoC 温度只有 53–67 °C,离 104.8 °C 的强制关机温度差得太远。同一套测试里,
spark1跑到 86 °C 都完全正常,连降频记录都没有。 - 没有内核崩溃:系统配了
kernel.panic=0,真发生 panic 只会卡死不会掉电;日志里既没有 panic,也没有 NVRM / Xid 报错,固件错误记录表(ACPI BERT)也是空的。 - 软件和固件一模一样:两台机器从底到顶核对了一遍——BIOS(
5.36_0ACUM028)、EC(3.5.11)、UEFI 与 SoC 固件(2.155.14/0.5.22)、GPU VBIOS(9A.0B.2D.00.00)、驱动(580.178.04)、DGX OS7.6.0、内核7.0.0-1025,甚至连 CX7 网卡、NVMe 固件以及 GPU 的应用时钟(2418 MHz)和最高时钟设置(3003 MHz)都一字不差,LVFS 和 apt 源也都是最新。
系统、固件、温度、内存全都没问题,那锅就只能扣在硬件本身了。
剥离业务复现:同款机器,功耗居然差出 40%
双机推理服务太重,排查效率低,所以我干脆写了单机压测脚本,把推理时的典型负载按从轻到重排成一条梯度:空闲 → decode 6 行(模拟 1 路请求 + 5 个投机解码草稿 token)→ decode 24 行(模拟 4 路并发)→ 2048 token prefill → 模拟突发负载 → 满功耗加满 CPU → 负载阶跃。
一跑起来,问题立刻稳定复现:spark0 每次都在从 decode 6 行切到 24 行后的 0.1–1.6 秒内准时断电。
把两台机器在切换前后的监控曲线叠在一起看,一眼就能看出反常的地方:
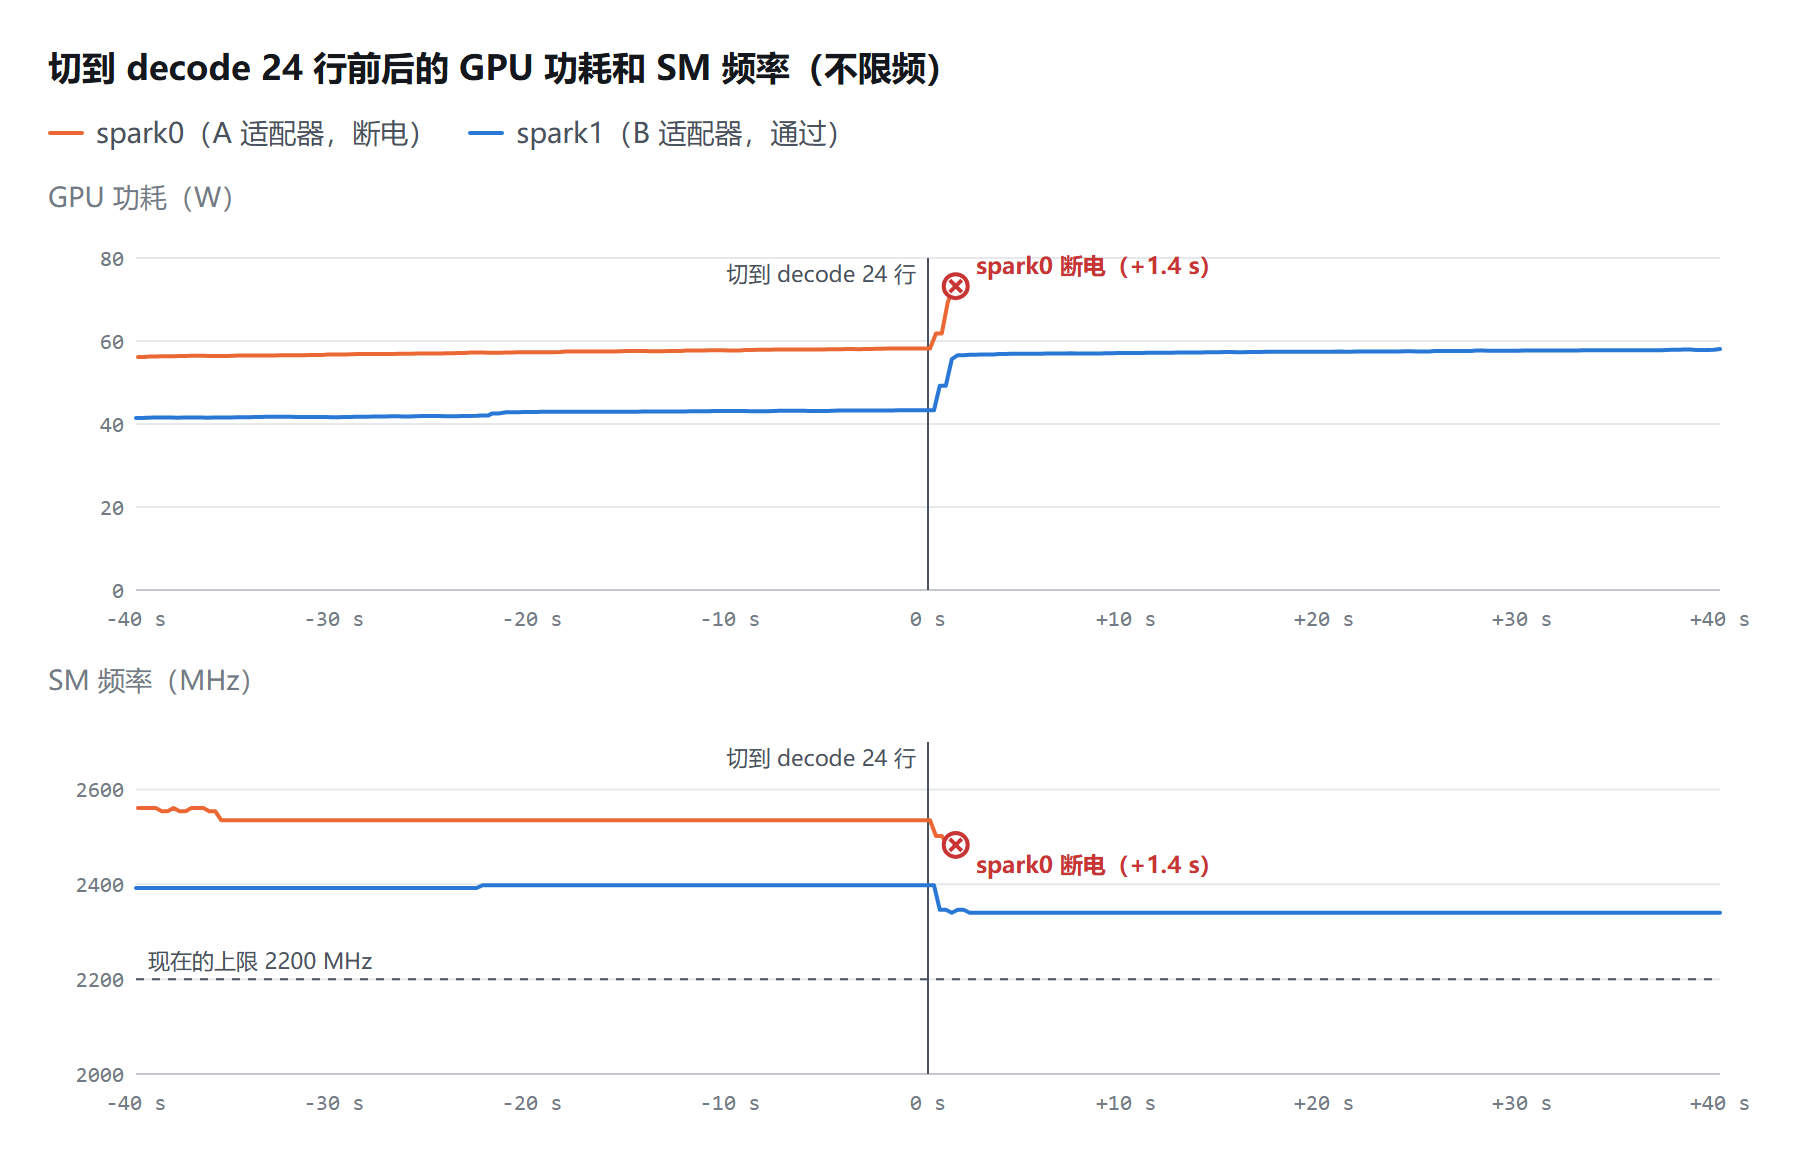
图里横轴是距离切换时刻的秒数,左半段是 decode 6 行,0 秒处切到 decode 24 行(功耗读数来自 NVML,约每 0.5 秒更新一次)。完全相同的固件、驱动和负载,两台同款机器的表现却差了一大截:
spark1:decode 6 行时安静地跑在 ~2400 MHz、42 W 左右;切到 24 行后涨到 57 W,顺顺利利跑完全部阶段。spark0:同样只是 decode 6 行,GPU 却自己冲到了 2535–2561 MHz,功耗高达 56–58 W——干完全一样的活,比同款兄弟机多烧了约 40% 的功率。等到 0 秒切到 24 行,功耗刚往上抬头(最后一条落盘读数停在 73.2 W),1.4 秒后直接黑屏断电。
明明两台机器的时钟配置完全一致,但在默认不限频状态下,spark0 的 boost 行为明显更激进(或者个体漏电/电压曲线更差,拉高频的功耗代价极高),直接把整机的供电余量吃紧了。
对调电源适配器:整机是主因,但原配电源也偏弱
一上负载就硬断电,另一个绕不开的怀疑对象就是外置电源适配器。于是把 spark0 原配的 A 适配器和 spark1 原配的 B 适配器对调了一遍,在同样一套测试下做了交叉验证:
| 机器 | 电源适配器 | 测试结果 |
|---|---|---|
| spark1 | B(原配) | 全部通过(GPU 最高约 67 W,SoC 最高 86 °C) |
| spark0 | A(原配) | 切到 decode 24 行后 1.4 秒断电 |
| spark0 | B(换上好电源) | 照样在切到 decode 24 行后 0.1 秒断电 |
| spark1 | A(spark0 原配) | 扛过了 decode,但在最重的满功耗 + 满 CPU 后的第一次负载切换时断电 |
这个 2×2 的交叉结果挺让人意外的:
spark0整机本身有问题。哪怕给它换上在spark1上完全正常的 B 适配器,它照样在并不算极限的 decode 24 行阶段秒断(甚至 0.1 秒就倒了,断电前最后读数才 58.6 W)。- A 适配器也偏弱。把
spark0原配电源插到原本正常的spark1上,前面虽然扛住了,但到了最重的满功耗 + 满 CPU 后的负载阶跃,直接把spark1也带断电了。
买两台同款 DGX Spark,不仅撞上一台体质异常、功耗飙高 40% 的机身,还顺带中了一块偏弱的原配电源,这出厂品控确实有点让人不放心。
90 W 跑满没事,60 W 的 EXL3 却秒断?
排查到这里,还有一个很反直觉的疑问:断电前记录到的 GPU 功耗不过 58–73 W,远没到 GB10 的功耗上限,为什么这就扛不住了?
为了搞清楚到底是什么样的负载能把 spark0 打死,我又补了两组不依赖真实模型权重的对照测试:
| 测试方式 | 依赖 | spark0(不限频)表现 |
|---|---|---|
| 真实权重 EXL3 | 引擎镜像 + 模型文件 | 在 decode 24 行稳定断电(2 次) |
| 纯 PyTorch 随机矩阵乘法 | 任意 PyTorch 容器 | 全部通过,GPU 持续跑在 89–96 W |
| 随机权重 EXL3(TensorFold 内核) | 无需模型文件 | 照样断电,甚至只跑 1 层也会在切 24 行后 1.6 秒断电 |
这个对比非常有意思:纯 PyTorch 大矩阵乘法把 GPU 持续推到 89–96 W,spark0 一点事都没有;反倒是平均功耗只有 60 W 左右的 EXL3 解码,哪怕只用随机权重跑单层,也能精准触发断电。
手头没有示波器,没法直接抓供电波形来做实证,但结合这两组截然相反的结果,背后的原因其实不难推断:
纯 PyTorch 的大矩阵乘法属于平滑、连续的计算负载,虽然平均功耗高达 90 W+,但电流变化平缓,供电电路和电源都能从容应对。而 EXL3 这类低比特量化解码完全不同——每一步都要密集调度上千个小 kernel,一边用整数运算实时解压 3–6 bit 权重,一边把 Tensor Core 和统一内存带宽同时跑满。这种负载很容易在微秒到毫秒尺度上打出极高的瞬态电流尖峰。
问题在于,NVML 约 0.5 秒更新一次、监控脚本 100 毫秒采一次的读数,本质上都是时间窗口里的平均值,早就把这种极短的尖峰平均掉了。表面上看功耗只有 60–70 W,实际上瞬间电流可能已经踩穿了整机 VRM 或电源的过流保护。再叠加 spark0 默认比 spark1 跑得更高、平白多耗 40% 功率,供电余量本来就更窄,自然在负载从 6 行跃升到 24 行的瞬间最先撑不住。
顺便一提,第三组「随机权重 EXL3」测试很实用——它直接调用 TensorFold 的 EXL3 内核,在显存里现场生成和 2.9bpw 形状位宽一致的随机张量,不用下载几百 GiB 模型文件就能在十几分钟内复现问题。我已经把它打包成了 Docker 测试脚本,回头找售后或者给其他 Spark 用户自测都很方便。
锁频 2200 MHz:功耗瞬间拉齐,推理速度几乎零损失
既然根源绕不开默认 boost 过高带来的 40% 额外功耗和瞬态冲击,在走售后之前,最直接的规避办法就是把 GPU 频率上限压下来。
上限选在 2200 MHz,参考了 Spheron 对 DGX Spark 功耗与降频的测试:DGX Spark 跑大模型推理时 GPU 频率通常在 2400–2550 MHz 波动,短时突发甚至可以摸到 3003 MHz,但受紧凑机身的散热和功耗墙限制,持续满载一段时间后终究会回落到 1500–2200 MHz。既然持续满载本来也就跑在这个区间,干脆直接用 nvidia-smi 锁在持续区间的上沿:
|
|
锁频之后,两台机器同时跑了一遍完整的 20 层随机权重 EXL3 压测,结果很戏剧性——不仅两台全部通过,原本差出 40% 的功耗几乎完全拉齐了:
| 压测阶段 | spark0 平均 / 峰值 | spark1 平均 / 峰值 |
|---|---|---|
| decode 6 行 | 33.3 W / 34.2 W | 34.0 W / 34.8 W |
| decode 24 行 | 44.9 W / 45.5 W | 45.3 W / 45.7 W |
| prefill 2048 | 52.0 W / 53.4 W | 52.0 W / 52.9 W |
| 模拟突发负载 | 37.3 W / 53.4 W | 37.8 W / 52.7 W |
| prefill + 满 CPU | 44.0 W / 53.4 W | 45.2 W / 53.2 W |
| 满功耗 + 满 CPU | 57.8 W / 64.3 W | 57.7 W / 62.1 W |
| 负载阶跃 | 19.9 W / 35.6 W | 20.0 W / 46.0 W |
| decode 直接切满功耗 | 57.9 W / 81.6 W | 57.7 W / 80.9 W |
同样是 decode 6 行,spark0 从不限频时的 56–58 W 直接降到了 33.3 W,和 spark1(34.0 W)几乎一致。连最狠的「decode 直接切满功耗」阶段,两台峰值都冲到 81 W、SoC 最高 85.7–85.8 °C,照样稳稳跑完。
最让人关心的性能损失问题,实测下来也几乎为零(甚至略有一点正向波动):
| 推理场景 | 不限频 | 锁频 2200 MHz |
|---|---|---|
| 写代码(800 token) | 100.5–102.0 tok/s | 103.5 tok/s |
| 中文短文(158 token) | 63.2 tok/s | 64.1 tok/s |
| 实测最高 SM 频率 | 2535–2561 MHz(spark0) | 2184 / 2190 MHz |
原因很简单:大模型 decode 本质上是**内存带宽受限(memory-bound)**的。GB10 的统一内存带宽天花板就摆在那里,GPU 核心盲目往上冲那三四百 MHz,对吐字速度几乎毫无帮助,纯粹是在白白拉高电压、多烧 40% 的电,顺便把供电推向崩溃边缘。
锁频之后重新跑回原本的业务场景(Codex 连续 15 轮工具调用,最大 prompt 19.5k token),spark0 全程再也没有断过电。
因为 nvidia-smi -lgc 重启后会失效,可以顺手配一个 systemd 服务,在 Docker 启动前自动锁频(驱动未就绪时最多重试 2 分钟,停用服务时会自动 nvidia-smi -rgc 恢复默认):
|
|
启用并确认生效:
|
|
写在最后
回头看这次折腾,部署 DeepSeek-V4.1-Flash 不过是恰好撞上了枪口,真正暴露出来的是 DGX Spark(至少在 HP ZGX Nano G1n 这批机器上)的硬件个体一致性和供电余量问题:
- 两台固件、系统、时钟配置完全一致的同款机器,默认 boost 策略和同负载功耗竟然能差出 40%;
- 遇到 EXL3 这类小 kernel 密集、瞬态电流波动剧烈的推理负载,哪怕平均功耗远低于标称值,供电依然可能直接触发断电;
- 就连原配外置电源适配器本身,也存在个体偏弱、极限负载下撑不住的情况。
如果你手上也有 DGX Spark 或其他 OEM 版 GB10 设备,主要用来跑本地大模型推理,直接把 GPU 频率锁在 2200 MHz 是一个几乎零成本的优化——decode 性能不掉,功耗和发热能省下一大截,供电安全边际也会宽裕很多。要是你的机器也碰上过“既非 OOM 也非过热,跑着跑着像拔插头一样黑屏”的故障,别光顾着折腾系统和推理引擎,建议直接从整机供电体质和电源适配器下手查起。
至于我手头这台 spark0 和那块偏弱的 A 适配器,对比数据已经够清楚了,准备带着这组测试结果直接找 HP 售后。在换机或修好之前,就先靠 2200 MHz 锁频稳着跑吧。